AINude jest przeznaczony wyłącznie dla osób dorosłych (18+). Materiały z udziałem nieletnich są zabronione. Wyraźna zgoda na użycie wizerunku jest wymagana. Treści intymne bez zgody są zabronione.
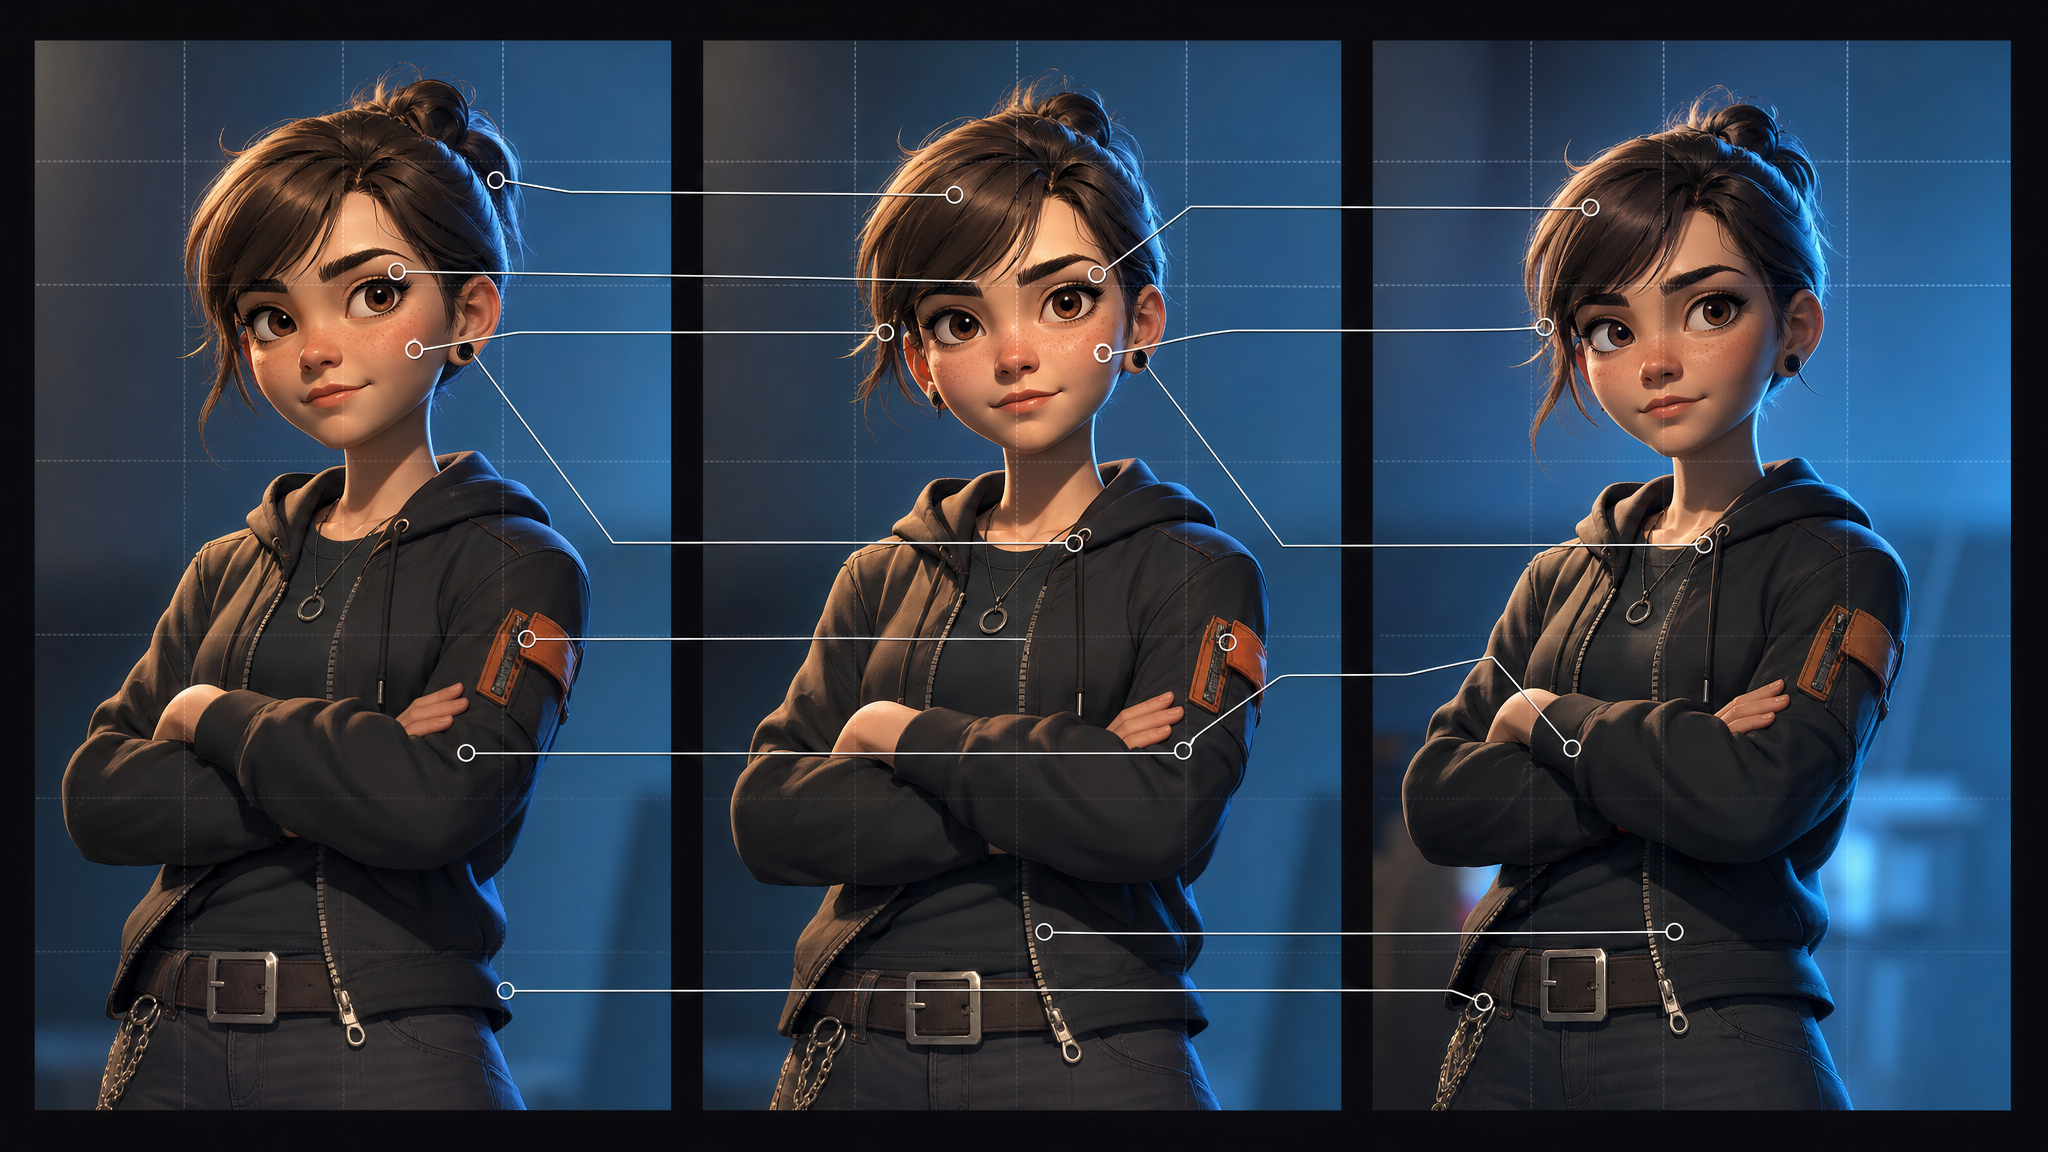
Tworzenie wideo z wykorzystaniem sztucznej inteligencji otwiera nowe możliwości dla twórców, jednak jednym z kluczowych wyzwań pozostaje utrzymanie spójności wizualnej postaci w kolejnych ujęciach. Zjawisko "dryfu tożsamości", gdzie wygląd postaci zmienia się w trakcie generowania klipu, może znacząco obniżyć jakość narracji i immersję. Ten przewodnik omawia techniczne aspekty i metody, które pozwalają na zachowanie stałego wyglądu postaci w generowanych materiałach wideo, od planowania po finalną weryfikację.
Znaczenie spójności postaci w wideo AI
W tradycyjnej kinematografii aktor zachowuje ten sam wygląd przez cały film, co jest fundamentalne dla rozpoznawalności i budowania więzi z widzem. W początkowych fazach rozwoju generatywnej sztucznej inteligencji, "aktor" w wideo mógł zmieniać rysy twarzy, kolor włosów czy sylwetkę co kilka sekund. Ten "dryf tożsamości" utrudniał tworzenie spójnych narracji i budowanie rozpoznawalności. Dla twórców treści, utrzymanie spójnej postaci jest kluczowe dla budowania marki, opowiadania historii i utrzymania zaangażowania odbiorców.
Kiedy poszukuje się rozwiązań w zakresie spójności postaci w wideo AI, istotne jest, aby narzędzie rozumiało różnicę między opisem tekstowym a wizualnym punktem odniesienia. Standardowe modele text-to-video często "halucynują" nowe detale przy każdej generacji. Współczesne metody pracy pozwalają na przesłanie obrazu źródłowego, który służy jako podstawa dla wyglądu postaci. Dzięki temu, niezależnie od tego, czy postać biegnie, mówi, czy wchodzi w interakcje w złożonej scenie, pozostaje rozpoznawalna.
Kluczowe cechy dla stabilnej generacji tożsamości
Aby skutecznie rozwiązać problem spójności, narzędzia do generowania wideo AI oferują szereg funkcji. Ich celem jest zapewnienie stabilnego wyglądu postaci, niezależnie od złożoności sceny czy długości klipu. Do najważniejszych należą:
Generowanie wideo na podstawie obrazu referencyjnego
To jedno z najpotężniejszych narzędzi do zapewnienia spójności. Polega na przesłaniu wyraźnego portretu lub zdjęcia całej sylwetki postaci. Sztuczna inteligencja wykorzystuje ten obraz jako strukturalny przewodnik dla każdej generowanej klatki. W przeciwieństwie do prostego zamieniania twarzy, które może wyglądać sztucznie, generowanie oparte na referencjach odbudowuje scenę wokół rzeczywistej geometrii postaci. Skutkuje to naturalnym ruchem i oświetleniem, które odpowiada tożsamości źródłowej.
Konwersja obrazu na wideo
Jeśli dysponujesz statycznym obrazem postaci w określonej pozie, możesz go bezpośrednio animować. Ta metoda zachowuje oryginalne dane pikselowe twarzy i ciała postaci, dodając ruch jedynie do kończyn, tła lub kąta kamery. Jest to idealne rozwiązanie dla subtelnych ruchów, takich jak oddychanie, mówienie czy chodzenie, gdzie priorytetem jest zachowanie dokładnego wyglądu źródłowego.
Weryfikacja polityki treści i rozdzielczości wyjściowej
Wiele platform wprowadza ograniczenia dotyczące typu treści, co może zmuszać twórców do stosowania obejść, które obniżają jakość. Niektóre narzędzia deklarują brak filtrów treści (z wyjątkiem treści nielegalnych), co pozwala na generowanie wideo bez narzucanych ograniczeń. Ważne jest, aby zweryfikować, czy platforma rzeczywiście umożliwia tworzenie treści oznaczanych jako NSFW lub o tematyce dla dorosłych, jednocześnie utrzymując spójność postaci. Deklarowana rozdzielczość wyjściowa, np. 1080p, również wymaga sprawdzenia, aby upewnić się, że generowane klipy są ostre i szczegółowe.
Obsługa wielu proporcji obrazu
Niezależnie od tego, czy tworzysz treści na platformy takie jak TikTok (9:16), YouTube (16:9), czy posty na Instagramie (1:1), narzędzie powinno obsługiwać różne proporcje obrazu. Silnik spójności powinien działać we wszystkich formatach, zapewniając prawidłowy wygląd postaci niezależnie od rozmiaru płótna.
Proces generowania wideo ze spójną postacią
Tworzenie wideo z ustaloną tożsamością postaci wymaga przestrzegania określonego procesu. Oto ogólne kroki, które pomagają w generowaniu spójnych treści wideo AI:
- Przygotowanie obrazu referencyjnego: Rozpocznij od wygenerowania lub przesłania wysokiej jakości obrazu postaci. Upewnij się, że twarz jest wyraźnie widoczna i dobrze oświetlona. Ten obraz będzie służył jako "kotwica" wizualna.
- Wybór trybu referencyjnego: W interfejsie generowania wideo wybierz opcję wykorzystania obrazu referencyjnego. Prześlij swój obraz-kotwicę. Informuje to sztuczną inteligencję, aby priorytetowo traktowała ten konkretny wygląd nad ogólnymi opisami tekstowymi.
- Formułowanie promptu ruchu: Opisz akcję, którą ma wykonać postać. Bądź precyzyjny w kwestii ruchu, ale unikaj zmieniania fizycznych deskryptorów, które mogłyby kolidować z obrazem referencyjnym. Na przykład, użyj "idzie pewnie ulicą", zamiast "blondynka idzie", jeśli Twoja postać referencyjna ma ciemne włosy.
- Ustalenie proporcji i długości: Wybierz odpowiednie proporcje obrazu (np. 9:16 dla wideo pionowego, 16:9 dla panoramicznego). Ustal pożądaną długość klipu.
- Generowanie i weryfikacja: Uruchom generowanie. Dokładnie przeanalizuj wynik. Jeśli postać nieznacznie "dryfuje", dostosuj siłę obrazu referencyjnego lub dopracuj prompt. Powtarzaj proces, aż uzyskasz zadowalający rezultat.
Przykłady skutecznych promptów dla spójności
Aby uzyskać najlepsze rezultaty, Twoje prompty powinny koncentrować się na akcji i środowisku, a nie na ponownym opisywaniu postaci. Przykładowo, zamiast pisać "kobieta z długimi brązowymi włosami biegnie przez las", jeśli masz już obraz referencyjny tej kobiety, możesz napisać po prostu "postać biegnie przez gęsty las, słońce przebija się przez korony drzew".
Wytyczne dotyczące proporcji obrazu
- 9:16 (Pionowe): Najlepsze dla krótkich filmów pionowych (np. TikTok, Reels, Shorts). Skupia się na pojedynczych postaciach i zbliżeniach.
- 16:9 (Panoramiczne): Idealne dla YouTube i scen kinowych. Pozwala na więcej szczegółów w tle i interakcje między dwiema postaciami.
- 1:1 (Kwadratowe): Przydatne dla zdjęć profilowych lub specyficznych kanałów mediów społecznościowych. Utrzymuje postać w centrum kadru.
Zastosowania wideo AI ze spójną postacią
Możliwość utrzymania spójnej tożsamości postaci w wideo AI otwiera wiele zastosowań:
- Tworzenie wirtualnych postaci: Twórcy mogą budować wirtualnych influencerów lub wykonawców, którzy pojawiają się w wielu filmach. Buduje to bazę fanów, którzy rozpoznają i łączą się z konkretną postacią. Bez spójności każdy film może wydawać się losową generacją, co utrudnia budowanie lojalności.
- Opowiadanie historii i odgrywanie ról: Dla twórców treści narracyjnych spójność jest kluczowa. Można opowiadać historię w wielu klipach, z tym samym bohaterem doświadczającym różnych wydarzeń. Dodaje to głębi i zaangażowania, których nie mogą zapewnić statyczne obrazy.
- Marketing i branding: Spójna postać może wyjaśniać produkty, demonstrować usługi lub angażować klientów w spersonalizowany sposób, budując rozpoznawalność marki.
Ocena kosztów generowania wideo
Większość narzędzi do generowania wideo AI działa w oparciu o system jednostek rozliczeniowych, często nazywanych "kredytami". Ważne jest, aby zrozumieć, jak przeliczane są te jednostki (np. 1 kredyt = 1 sekunda wideo, lub 1 kredyt = X klatek). Aby ocenić koszt, należy:
- Zidentyfikować jednostkę rozliczeniową: Czy platforma rozlicza się za sekundę, za klatkę, czy za inny parametr?
- Określić koszt jednostkowy: Jaki jest koszt jednej jednostki (np. 1 sekundy wideo)?
- Obliczyć całkowity koszt: Pomnóż koszt jednostkowy przez przewidywaną długość lub liczbę generacji potrzebnych do projektu.
- Porównać modele płatności: Niektóre platformy oferują płatności jednorazowe (pay-as-you-go), inne subskrypcje miesięczne. Wybór zależy od intensywności użytkowania.
Porównanie podejść do spójności postaci w narzędziach AI
Różne narzędzia do generowania wideo AI oferują odmienne podejścia do problemu spójności postaci. Poniżej przedstawiono kluczowe kryteria, które należy wziąć pod uwagę przy ocenie platform:
| Kryterium Oceny | Podejście oparte na referencjach (np. obraz) | Podejście oparte wyłącznie na promptach tekstowych |
|---|---|---|
| Spójność postaci | Wysoka (obraz jako podstawa wizualna) | Niska do średniej (ryzyko "dryfu tożsamości") |
| Elastyczność polityki treści | Deklarowane wsparcie dla szerszego zakresu treści (np. NSFW) | Często z restrykcyjnymi filtrami treści |
| Deklarowana rozdzielczość | Często deklarowana wysoka rozdzielczość (np. 1080p) | Zmienna, często niższa lub skalowana w górę |
| Deklarowane podejście do prywatności | Deklarowane opcje anonimowości i płatności kryptowalutami | Często wymaga weryfikacji tożsamości, powiązane z danymi osobowymi |
| Metody generowania | Obraz do wideo, wideo do wideo, referencje | Tekst do wideo, proste animacje |
Powyższa tabela przedstawia ogólne różnice w deklarowanych możliwościach. Użytkownicy powinni zawsze weryfikować te deklaracje poprzez testowanie narzędzi i zapoznawanie się z ich dokumentacją oraz polityką prywatności.
Należy również pamiętać, że tworzenie i rozpowszechnianie treści syntetycznych, które podszywają się pod inne osoby, służą oszustwu lub manipulacji, jest zabronione.
Praktyczny tygodniowy proces pracy
- Najpierw określ efekt: krótka reklama, scena fabularna, klip instruktażowy, wizualizacja muzyczna, demo produktu lub post społecznościowy.
- Wypisz potrzebne materiały: prompt, obraz referencyjny, ujęcie produktu, projekt postaci, kadr storyboardu, scenariusz lub audio.
- Generuj i montuj małymi etapami, zamiast próbować ukończyć cały film za jednym razem.
- Sprawdź spójność, tempo, czytelność obrazu, miejsce na napisy, potrzeby dźwiękowe i format platformy.
- Zapisz prompt, materiały źródłowe i ustawienia eksportu, aby łatwiej odtworzyć kolejną wersję.
Podsumowanie
Praca nad wideo wspierana przez AI daje najlepsze rezultaty, gdy jest traktowana jako powtarzalny system produkcyjny. Pomysł twórczy nadal ma znaczenie, ale proces wymaga też jasnych materiałów wejściowych, kontrolowanych iteracji i etapu oceny, który zmienia surowe generacje w gotowy przekaz. Kluczowe jest zrozumienie technicznych mechanizmów stojących za spójnością postaci, takich jak wykorzystanie obrazów referencyjnych, oraz świadome zarządzanie promptami i parametrami generacji.
Następny krok
Aby eksperymentować z generowaniem wideo na podstawie obrazów lub tekstu, możesz sprawdzić dostępne narzędzia. Poznaj możliwości generowania wideo z obrazu: AINude - Image to Video Odkryj generowanie wideo z tekstu: AINude - Text to Video
Najczęściej zadawane pytania
Czym jest wideo AI ze spójną postacią?
Wideo AI ze spójną postacią odnosi się do generowanych klipów wideo, w których główny bohater zachowuje te same rysy twarzy, typ sylwetki i ogólny wygląd w różnych scenach i pod różnymi kątami. Osiąga się to zazwyczaj poprzez wykorzystanie obrazów referencyjnych, a nie tylko promptów tekstowych.
Czy mogę tworzyć wideo z treściami oznaczanymi jako NSFW ze spójną postacią?
Możliwość tworzenia treści oznaczanych jako NSFW ze spójną postacią zależy od polityki treści danej platformy. Niektóre platformy deklarują brak filtrów treści (z wyjątkiem treści nielegalnych), co pozwala na generowanie takich materiałów. Ważne jest, aby zweryfikować politykę platformy i upewnić się, że pozwala ona na utrzymanie tożsamości postaci w różnych scenariuszach bez blokowania lub cenzurowania pracy.
Jak zapewnić, że moja postać wygląda tak samo w każdym wideo?
Aby zapewnić spójność, należy użyć funkcji obrazu referencyjnego. Prześlij wyraźne, wysokiej jakości zdjęcie postaci przed generowaniem. Prompty tekstowe powinny koncentrować się na akcji i środowisku, unikając sprzecznych opisów fizycznych, które mogłyby zmienić wygląd postaci.
Jakie są koszty generowania wideo?
Koszty generowania wideo są zazwyczaj oparte na jednostkach rozliczeniowych, takich jak sekundy lub klatki. Aby ocenić koszt, należy sprawdzić, ile jednostek kosztuje jedna sekunda wideo i pomnożyć to przez planowaną długość klipu. Warto również porównać modele płatności (jednorazowe vs. subskrypcje) oferowane przez różne platformy.
Czy platforma obsługuje zamianę twarzy (face swapping)?
Niektóre narzędzia koncentrują się na generowaniu opartym na referencjach i animacji obrazu do wideo, zamiast na tradycyjnej zamianie twarzy. Metody te często zapewniają wyższą jakość i bardziej naturalny ruch, jednocześnie utrzymując tożsamość postaci bez artefaktów często występujących w narzędziach do deepfake'ów. Warto sprawdzić, czy narzędzie oferuje dedykowaną funkcję zamiany twarzy, czy też osiąga podobne efekty poprzez inne mechanizmy.